Se il modello calcola compatibilità[2] invece di comprendere intenzioni, allora l’intenzione deve arrivare da fuori. Questa è la ragione tecnica, non retorica, per cui il regista resta il regista. Non perché sia più creativo di una macchina, ma perché nel sistema che state costruendo insieme lui è l’unico componente che sa cosa deve accadere in questa scena[3] e perché adesso.
C’è però un modo sbagliato di prendere questa idea, ed è il più diffuso: credere che comandare significhi descrivere meglio. La descrizione ha un tetto basso. Aggiungere aggettivi restringe il campo delle immagini possibili, ma non lo chiude, e oltre un certo punto le parole cominciano a competere fra loro invece di sommarsi. C’è anche un limite meno intuitivo: in un’istruzione lunga il vincolo[4] che ti sta più a cuore non pesa in proporzione all’importanza che gli dai tu — la ricerca sui contesti lunghi mostra che l’informazione collocata in mezzo viene usata peggio di quella all’inizio e alla fine. Un prompt di quaranta righe non è quaranta volte più preciso di uno di quattro: è più difficile da far rispettare.
Comandare, in pratica, significa altro:
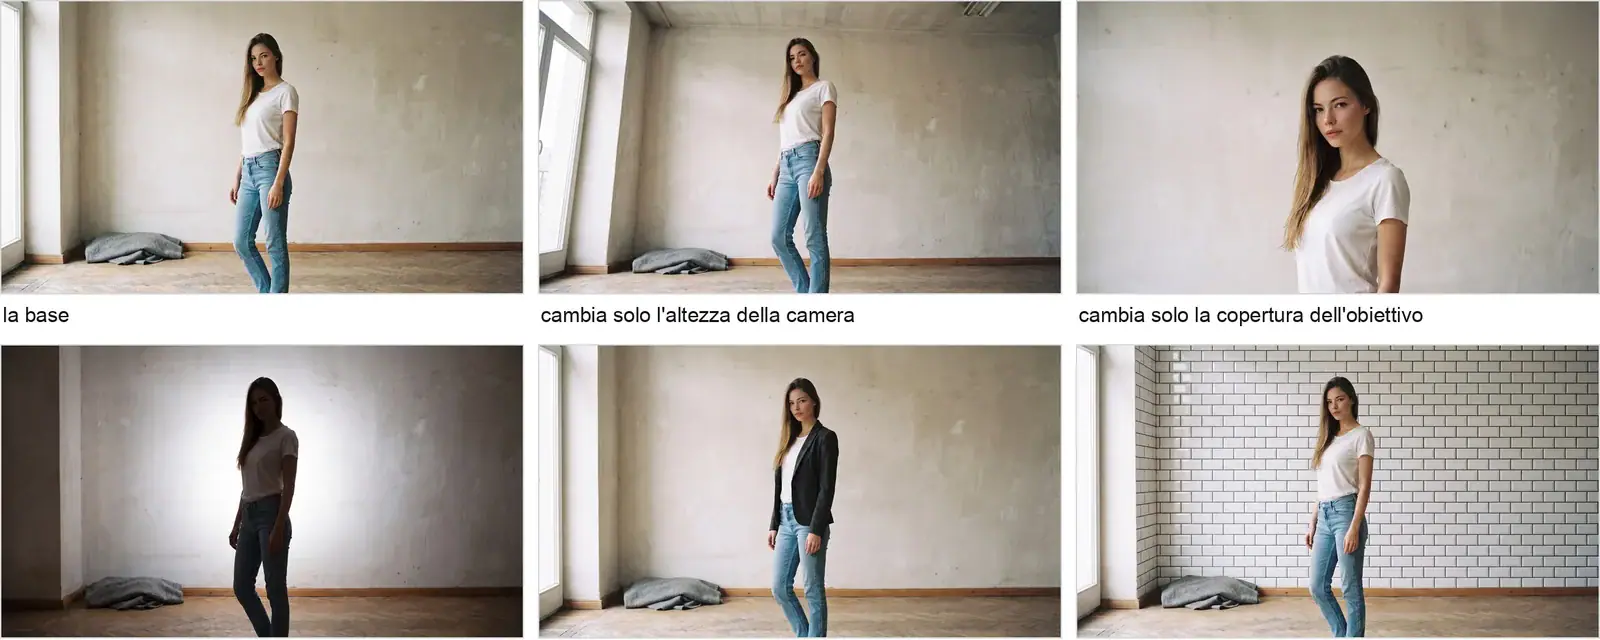
- Sostituire parole con vincoli. Una posa, un contorno, una profondità, una fotografia di riferimento valgono più di qualsiasi aggettivo, perché non descrivono: impongono.
- Decidere prima cosa non è negoziabile. Un’inquadratura[5] ha di solito una cosa che deve essere giusta e sei che possono variare. Se non la dichiari, la macchina scommette.
- Verificare invece di sperare. Il controllo esiste solo se sai dire, guardando il risultato, se il vincolo è stato rispettato …e se sai rifare il risultato domani.
- Tenere la decisione. Cosa entra nel montaggio[6], cosa è credibile, cosa è di buon gusto: nessuna di queste è delegabile, e nessuno le sta delegando in tua assenza.
Il resto di questo manuale è un catalogo di modi per spostare potere decisionale dalla macchina a te. È l’unica direzione che porti da qualche parte, perché è l’unica in cui il risultato diventa ripetibile, e quindi verificabile e vendibile.
Come è nata la figura
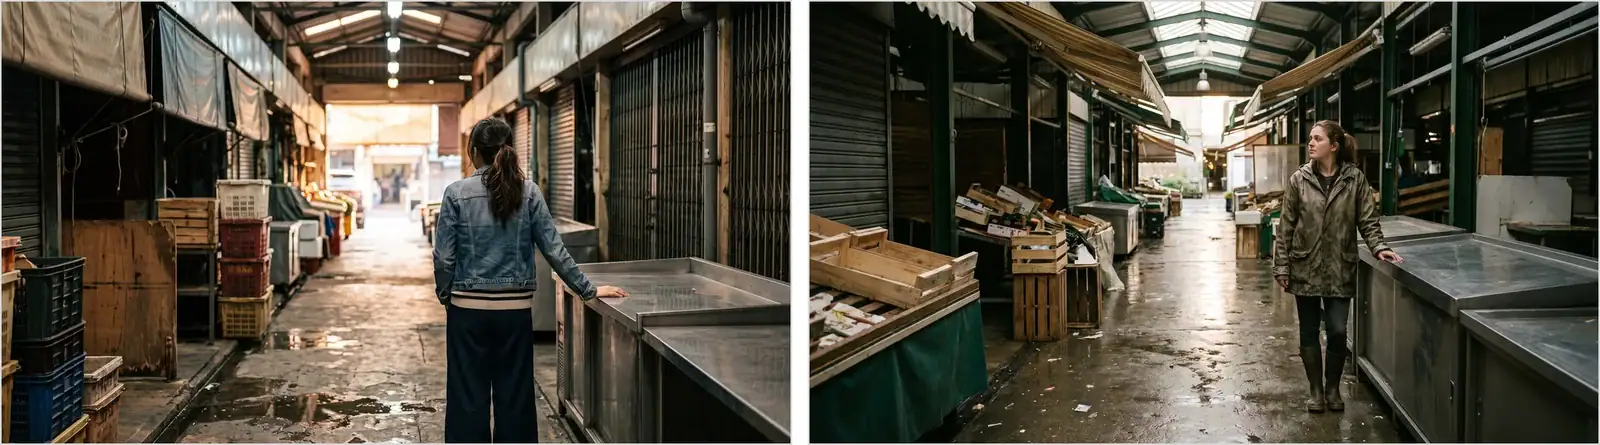
Nano Banana Pro, 2K, 16:9[7]. Serie di 2 riquadri generati separatamente, senza incatenarli l’uno all’altro: la differenza fra loro è ciò che la figura mostra. Nessuna immagine di riferimento.
Prompt del riquadro 1 (quattro parole), in inglese come è stato inviato al modello:
Il prompt
A woman waiting at a station.Prompt del riquadro 2 (quaranta parole), in inglese come è stato inviato al modello:
A woman of about thirty waits alone on a suburban railway platform on a grey weekday morning, wearing a dark wool coat and holding a paper cup, her weight on one leg, looking down the empty track towards the bend where the train will appear, with a covered footbridge behind her and rain on the concrete.Il comando, o la richiesta (scritta in linguaggio naturale), che un utente fornisce a un modello di intelligenza artificiale generativa per istruirlo sul contenuto che deve creare (es. "genera un'inquadratura grandangolare di una foresta al tramonto con stile anamorfico").
Il criterio con cui il modello calcola quanto un risultato si accorda con testo, immagini e condizioni ricevuti. Non equivale alla comprensione di un'intenzione. Per questo l'intenzione deve essere resa esplicita da chi dirige il lavoro.
Unità narrativa fondamentale del film che si svolge in un unico luogo e in un tempo continuo; ogni cambiamento di location o di tempo richiede la creazione di una nuova scena (e relativa intestazione).
Indica una cosa che deve restare in un certo modo, per esempio una posa, una disposizione o un'immagine di riferimento. Serve a spostare il risultato verso una scelta precisa invece di affidarla alla descrizione libera. Può essere scritto nel prompt o fornito come materiale visivo.
L'unità minima del linguaggio cinematografico. Tecnicamente, è la porzione di spazio (fisico o virtuale) delimitata dai bordi dell'obiettivo della macchina da presa. Nel montaggio, corrisponde a una registrazione continua tra due stacchi (tagli).