C’è una frase che conviene tenere a mente per tutto il manuale: “il modello non ragiona, calcola”. Non è una svalutazione ed è meno filosofica di quanto sembri. È l’informazione che decide come gli si parla e cosa si può pretendere. Un generatore di immagini non immagina la scena[1] e poi la disegna: parte da rumore e lo sottrae per gradi, e a ogni passo stima come correggere lo stato in cui si trova. Alla fine di quella catena c’è un’immagine, ma nessuno l’ha progettata: è emersa come la configurazione più compatibile con il rumore di partenza, la condizione data e ciò che il modello ha imparato.
Per il testo il meccanismo è diverso ma la conclusione è la stessa. Un modello linguistico[2] non capisce l’istruzione: la trasforma in vettori e produce la continuazione statisticamente più coerente con essi. E l’allineamento fra parole e immagini, che è ciò che rende possibile scrivere «controluce» e ottenere un controluce, è appreso per correlazione[3] su enormi quantità di coppie testo-immagine. Non è una traduzione: è un’associazione, con tutte le lacune e le storture di ciò su cui è stata costruita.
Da qui tre conseguenze pratiche, che tornano in tutti i capitoli successivi:
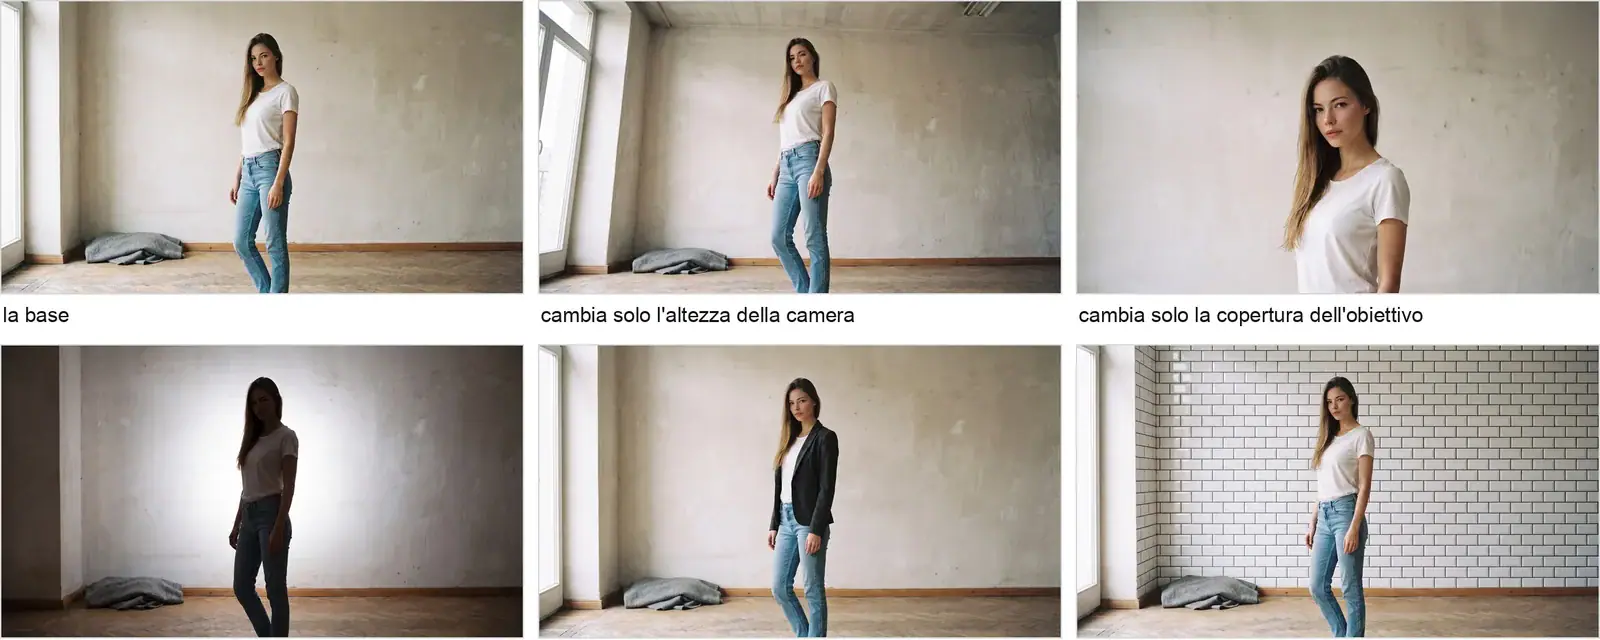
- Non c’è una scena dietro l’immagine generata. Il modello non conserva una geometria tridimensionale della stanza che ti ha appena mostrato. Se cambi inquadratura[4], non ruota una stanza: ne calcola un’altra.
- Le allucinazioni visive non sono “errori” del modello. Le mani sbagliate, i riflessi impossibili, gli oggetti che si fondono sono il percorso della macchina attraverso configurazioni matematicamente vicine e visivamente incompatibili. Sapere che sono struttura e non difetto cambia il modo di correggerle.
- Le parole rare pesano meno. Un termine tecnico raro o una relazione spaziale complessa attivano associazioni incomplete: non perché il modello «non capisca», ma perché su quel nesso ha visto poco.
Chi lavora con l’AI e resta deluso, quasi sempre ha chiesto comprensione a qualcosa che offre compatibilità[5]. Chi ottiene risultati ha smesso di chiedere e ha iniziato a vincolare e usare reference[6].
Come è nata la figura
Nano Banana Pro, 2K, 16:9[7]. Serie di 2 riquadri generati separatamente, senza incatenarli l’uno all’altro: la differenza fra loro è ciò che la figura mostra. Nessuna immagine di riferimento.
Prompt[8] del riquadro 1 (prima generazione), in inglese come è stato inviato al modello:
Il prompt
A woman in her twenties stands at the end of a covered market aisle at closing time, one hand resting on an empty steel counter, looking away from the camera towards the light at the far end. Late daylight, wet concrete floor, folded awnings, crates stacked along the walls. Editorial documentary finish, natural contrast, muted palette.Prompt del riquadro 2 (seconda generazione), in inglese come è stato inviato al modello:
A woman in her twenties stands at the end of a covered market aisle at closing time, one hand resting on an empty steel counter, looking away from the camera towards the light at the far end. Late daylight, wet concrete floor, folded awnings, crates stacked along the walls. Editorial documentary finish, natural contrast, muted palette.Unità narrativa fondamentale del film che si svolge in un unico luogo e in un tempo continuo; ogni cambiamento di location o di tempo richiede la creazione di una nuova scena (e relativa intestazione).
Trasforma le istruzioni scritte in una rappresentazione numerica. Non interpreta le intenzioni come una persona, ma calcola quali parti di testo sono più compatibili con quelle ricevute. Può aiutare a costruire un prompt, purché le scelte di scena restino controllate.
Indica che due elementi ricorrono insieme negli esempi esaminati dal sistema. Un modello può apprendere questi legami tra parole e immagini senza sapere perché esistono. Per questo può associare una richiesta a dettagli non voluti.
L'unità minima del linguaggio cinematografico. Tecnicamente, è la porzione di spazio (fisico o virtuale) delimitata dai bordi dell'obiettivo della macchina da presa. Nel montaggio, corrisponde a una registrazione continua tra due stacchi (tagli).
Il criterio con cui il modello calcola quanto un risultato si accorda con testo, immagini e condizioni ricevuti. Non equivale alla comprensione di un'intenzione. Per questo l'intenzione deve essere resa esplicita da chi dirige il lavoro.